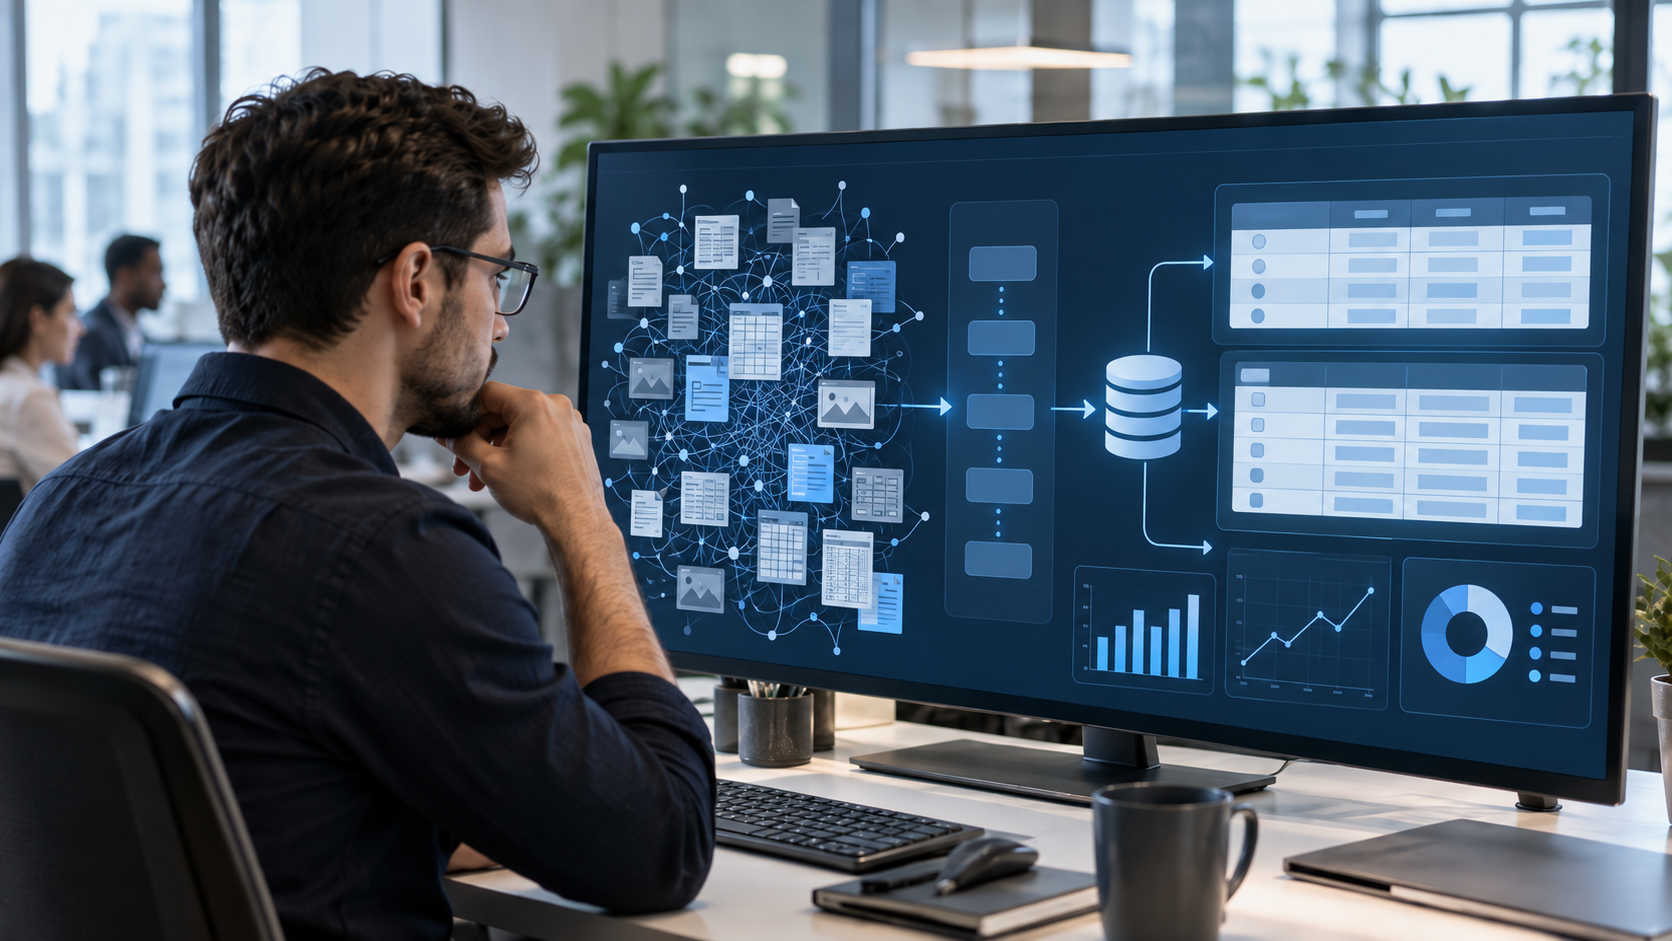
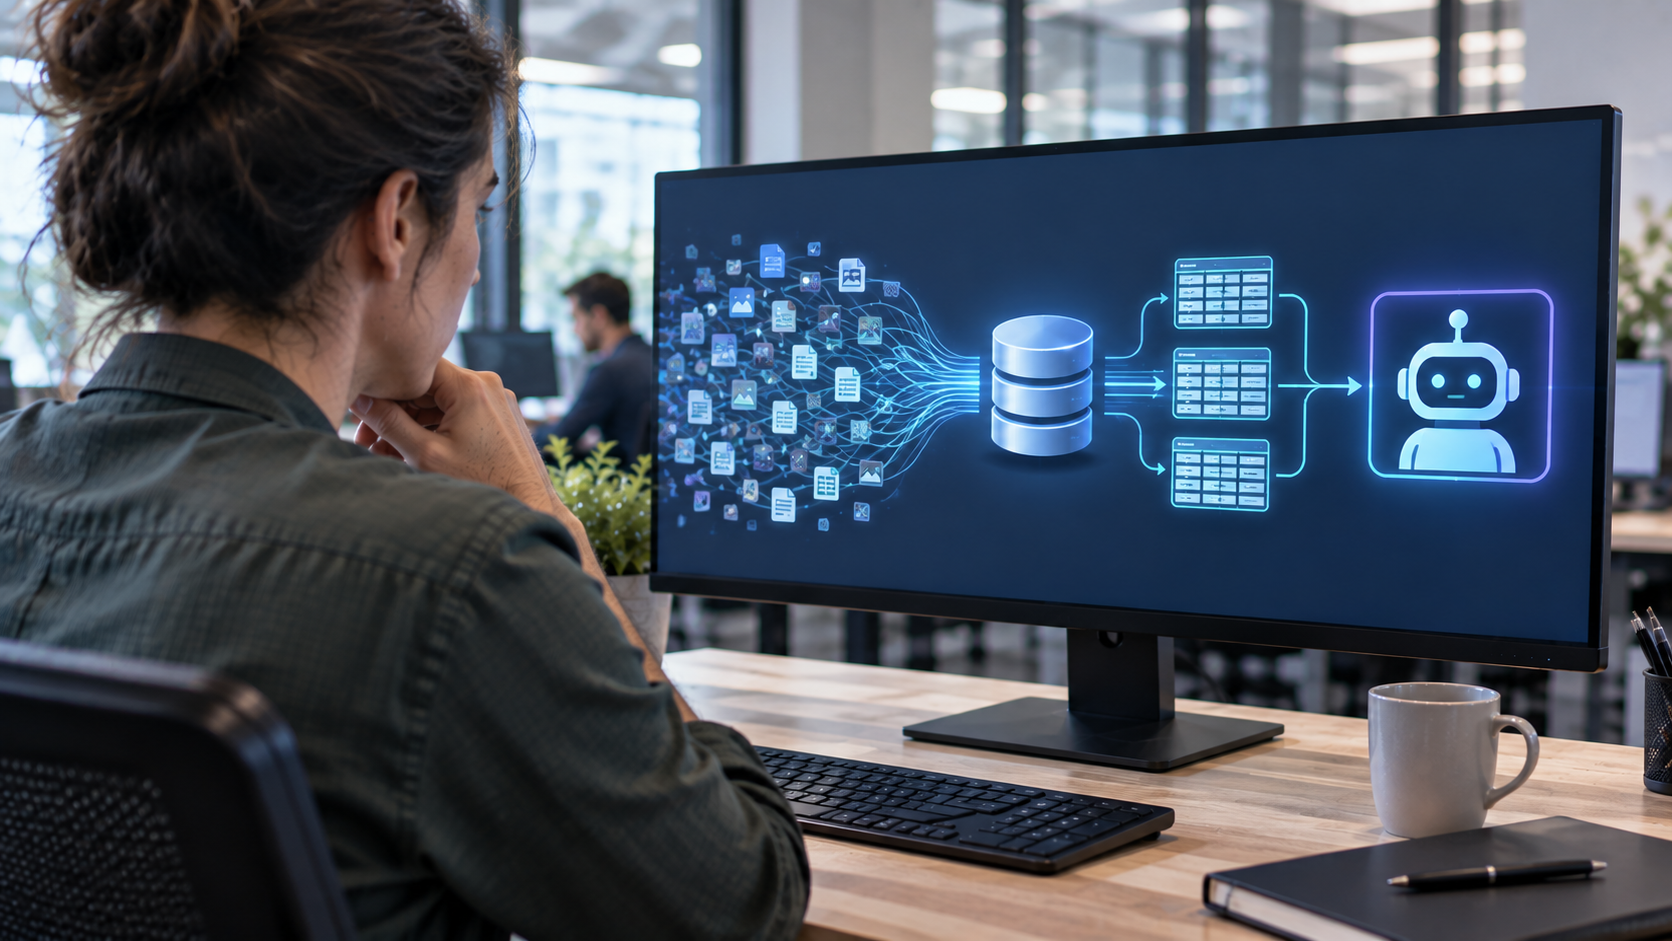
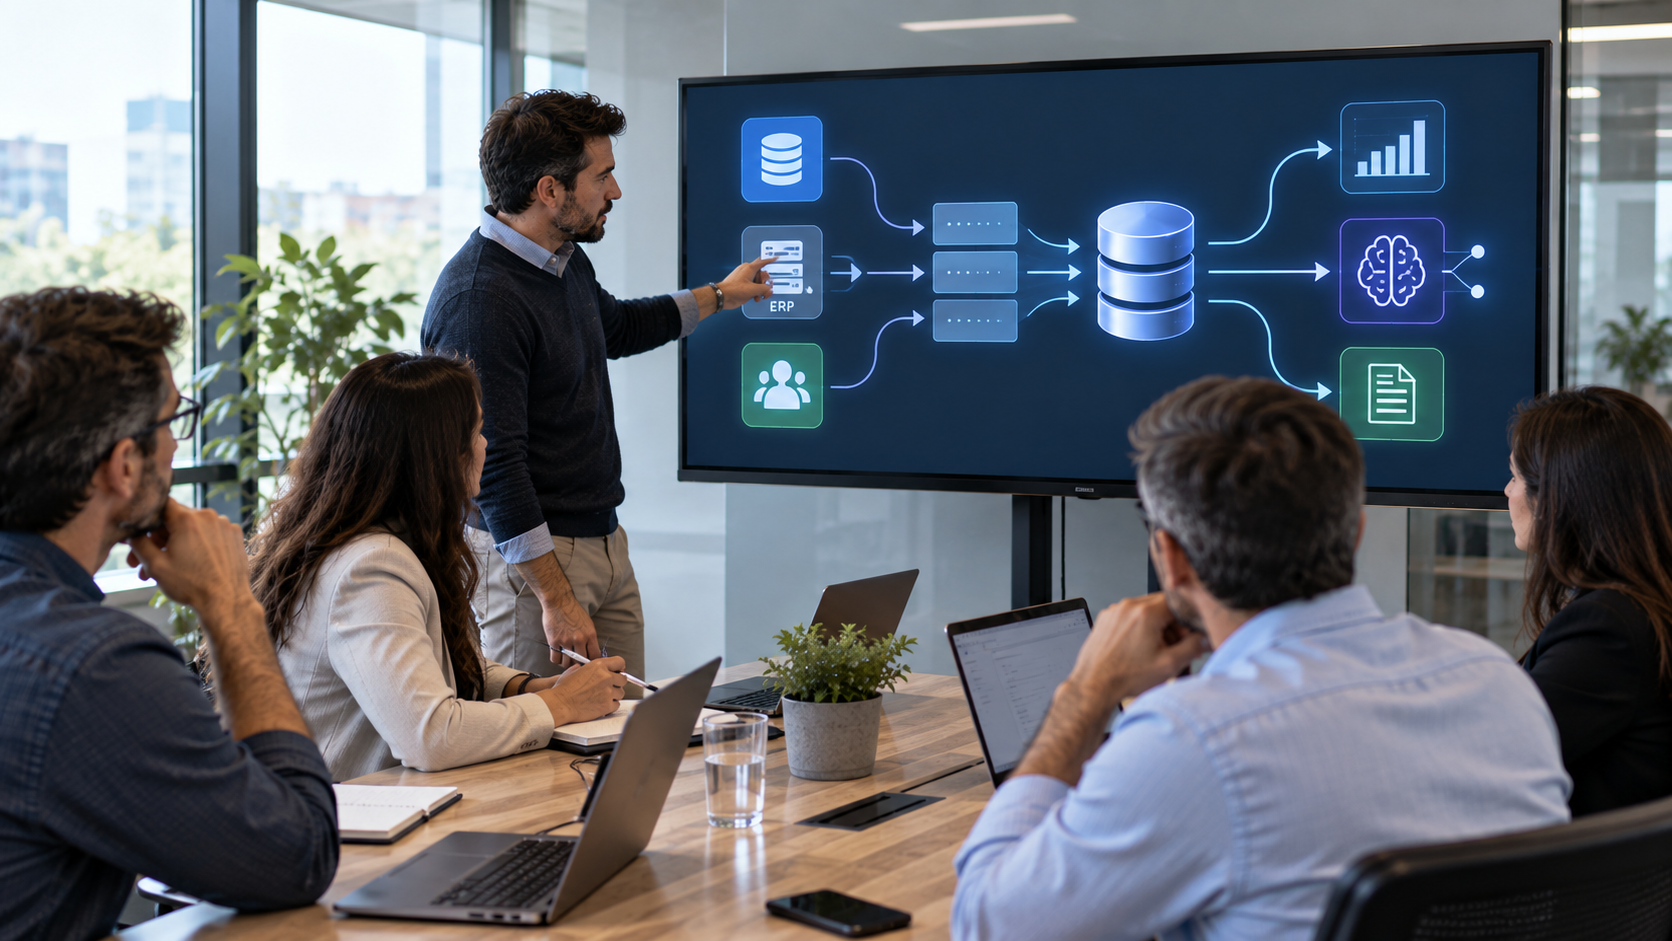
La preparación de datos para IA agéntica es uno de los pasos fundamentales para que una pyme pueda automatizar procesos con precisión. Los agentes de IA son tan eficaces como la información a la que acceden: si los datos están fragmentados, desactualizados o carecen de contexto, cualquier intento de autonomía comienza con una desventaja.
En 2026, muchas empresas siguen centrando sus proyectos de Inteligencia Artificial en elegir el modelo o la herramienta.
Pero el verdadero problema suele estar debajo.
La IA agéntica ha transformado el software de simples sistemas de registro a sistemas capaces de analizar información y ejecutar acciones. Para que un agente pueda gestionar una incidencia financiera, priorizar un cliente o coordinar un proceso operativo, necesita comprender qué significan los datos que está utilizando.
Necesita contexto.
Y ese contexto debe construirse.
El problema del archipiélago digital
La realidad técnica de muchas organizaciones continúa siendo un conjunto de sistemas desconectados.
Ventas trabaja con el CRM.
Operaciones consulta el ERP.
Finanzas utiliza otras aplicaciones.
Y una parte importante de la información termina repartida entre hojas de cálculo, documentos, correos electrónicos y bases de datos.
Cada herramienta puede funcionar correctamente de manera aislada.
El problema aparece cuando un agente necesita entender el negocio completo.
Imaginemos que debe decidir si conviene priorizar un pedido de un determinado cliente. Para hacerlo correctamente podría necesitar conocer su historial comercial, pagos pendientes, margen, inventario disponible e incidencias anteriores.
Si cada dato vive en un sistema diferente y no existe una relación clara entre ellos, el agente obtiene una imagen incompleta.
La empresa tiene los datos.
Pero no tiene necesariamente el contexto.
El fin de la IA como caja negra: la importancia del contexto
A diferencia de un chatbot limitado a responder una pregunta, los agentes trabajan orientados a objetivos y pueden intervenir en diferentes etapas de un proceso.
Eso aumenta el valor potencial de la tecnología.
También aumenta la importancia de la calidad de la información.
Los analistas advierten que el lanzamiento de agentes fallará en un 50 % de los casos debido a una gobernanza insuficiente y a problemas relacionados con la información de origen.
Ningún agente puede compensar completamente un modelo de datos roto.
Si la infraestructura no permite comprender quiénes son los mejores clientes, cuáles son los márgenes reales o dónde existen incidencias operativas, la IA corre el riesgo de automatizar el caos.
Por eso, antes de aumentar la autonomía, hay que aumentar la calidad del contexto.
De tener datos a tener datos utilizables
Preparar datos para IA no consiste simplemente en reunir toda la información en una gran base de datos.
Los datos deben ser utilizables.
Eso implica responder preguntas básicas:
¿De dónde procede cada dato?
¿Cuándo se actualizó?
¿Qué sistema es la fuente oficial?
¿Quién puede modificarlo?
¿Existe duplicado en otra aplicación?
¿Qué significa exactamente dentro del negocio?
Un ejemplo sencillo aparece con el concepto de cliente activo.
Ventas puede considerar activo a cualquier cliente que haya comprado durante los últimos 12 meses. Finanzas podría utilizar otra definición. Marketing podría incluir también oportunidades abiertas.
Para una persona que conoce la organización, esa diferencia puede resultar evidente.
Para un agente que debe actuar automáticamente, no.
La preparación de datos también consiste en eliminar esas ambigüedades.
Una única fuente de verdad
El objetivo no es obligatoriamente almacenar toda la información en el mismo lugar.
Lo importante es que exista una referencia fiable para cada dato crítico.
Si un agente consulta el saldo de un cliente, debe saber qué sistema contiene el valor válido.
Si consulta inventario, necesita identificar cuál es la fuente actualizada.
Si encuentra información contradictoria, debe existir una regla para determinar qué dato prevalece.
Esta lógica crea una única fuente de verdad, aunque técnicamente la información continúe distribuida entre distintas plataformas.
Para conseguirlo, resulta fundamental eliminar los silos de datos y preparar el ERP y CRM para la IA, de modo que la información pueda conectarse y utilizarse con un contexto coherente entre sistemas.
Antes de predecir, hay que integrar.
Antes de automatizar, hay que entender.
Los tres pilares de unos datos AI-Ready
Preparar los cimientos técnicos para la era agéntica requiere trabajar sobre tres capacidades especialmente importantes.
1. Integración profunda mediante APIs
Los agentes necesitan acceder a los sistemas donde vive la información empresarial.
Las APIs permiten hacerlo de forma estructurada.
En lugar de obligar a una persona a consultar una aplicación y trasladar manualmente el resultado a otra, un agente puede solicitar la información necesaria directamente al sistema autorizado.
El éxito de la IA depende en un 96 % de una conectividad fluida.
Por ejemplo, un agente comercial podría consultar el CRM para identificar una oportunidad, comprobar en el ERP si existe disponibilidad y recuperar posteriormente las condiciones comerciales correspondientes.
Tres fuentes diferentes.
Un único proceso.
Para conseguirlo, no basta con que las aplicaciones almacenen información. Deben poder intercambiarla de manera controlada.
2. Capa semántica y grafos de conocimiento
Conectar sistemas resuelve una parte del problema.
La siguiente consiste en conseguir que la IA entienda qué representan los datos.
Ahí entra la capa semántica.
Una base de datos puede contener una cifra como 12.500.
Por sí sola, significa poco.
La capa semántica aporta contexto: esos 12.500 euros pueden representar la facturación acumulada de un cliente durante los últimos seis meses.
Ahora el agente puede interpretar el dato dentro de una lógica empresarial.
Los grafos de conocimiento amplían esta idea al establecer relaciones entre entidades.
Un cliente está relacionado con pedidos.
Los pedidos con productos.
Los productos con proveedores.
Los proveedores con incidencias.
Estas conexiones permiten que la IA no analice únicamente registros aislados, sino una red de relaciones empresariales.
3. RAG agéntica: recuperar información antes de actuar
Otra pieza importante es la Generación Aumentada por Recuperación (RAG).
Su función es permitir que el sistema recupere información relevante desde fuentes empresariales antes de generar una respuesta o tomar determinadas decisiones.
Un agente que recibe una consulta sobre las condiciones de devolución de un cliente podría recuperar primero el contrato correspondiente, la política interna y el historial de pedidos.
Después trabaja con ese contexto.
En un entorno agéntico, esta lógica puede incorporarse dentro de procesos más amplios.
El agente recupera información.
La interpreta.
Consulta otras herramientas.
Y continúa el flujo según las reglas establecidas.
El objetivo es reducir la dependencia de conocimiento genérico y aumentar el peso de información empresarial actualizada y pertinente.
Calidad del dato antes que cantidad
Acumular millones de registros no garantiza que una empresa esté preparada para utilizar IA.
En muchos casos, un conjunto menor de datos correctamente estructurados resulta más útil que una enorme cantidad de información inconsistente.
Los problemas habituales son conocidos:
Clientes duplicados.
Campos incompletos.
Categorías diferentes para representar lo mismo.
Fechas almacenadas con formatos incompatibles.
Productos con identificadores distintos entre ERP y CRM.
Documentos sin una clasificación consistente.
Cada pequeña inconsistencia aumenta la dificultad cuando la IA debe combinar información de distintas fuentes.
Por eso, la preparación debería comenzar identificando qué datos necesita realmente cada caso de uso.
No es necesario limpiar toda la empresa antes de empezar.
Hay que limpiar primero aquello que alimentará el proceso que queremos automatizar.
Gobernanza: quién puede ver y modificar cada dato
Preparar datos para agentes también significa controlar el acceso.
Un agente de atención al cliente puede necesitar consultar pedidos e incidencias.
Eso no implica que necesite acceder a nóminas, información financiera completa o documentación confidencial.
La arquitectura debe definir qué información puede consultar cada agente, qué acciones puede realizar y cuáles requieren autorización humana.
La gobernanza se vuelve especialmente relevante cuando diferentes departamentos empiezan a incorporar herramientas de IA por separado. Sin una estrategia común pueden aparecer agentes con permisos excesivos, fuentes duplicadas y procesos difíciles de auditar.
Esta base debe integrarse dentro de un ecosistema de software a medida e IA capaz de conectar aplicaciones, datos y procesos sin convertir cada nueva automatización en otra pieza aislada de la infraestructura.
Preparar el dato también significa preparar sus reglas de uso.
Soberanía de datos en la era agéntica
En el entorno regulatorio actual, marcado por el EU AI Act, la gestión de la información no es únicamente una cuestión de productividad.
También afecta al control y cumplimiento.
Las empresas necesitan conocer qué información utilizan sus sistemas, dónde se procesa y qué mecanismos existen para limitar su acceso.
La soberanía de datos consiste precisamente en mantener ese control.
Una empresa puede utilizar infraestructura externa y seguir gobernando correctamente su información.
Lo importante es disponer de políticas, permisos, trazabilidad y mecanismos técnicos que permitan saber qué ocurre con los datos.
A medida que aumenta la autonomía de los agentes, esta visibilidad se vuelve más importante.
Del dato bruto al dato preparado para agentes
Un enfoque práctico puede comenzar seleccionando un proceso concreto.
Por ejemplo, la gestión de incidencias de clientes.
Primero se identifican los datos necesarios: cliente, contrato, pedidos, facturas, incidencias anteriores y políticas aplicables.
Después se localiza dónde reside cada elemento.
A continuación se determina cuál es la fuente válida, cómo se conecta y qué nivel de acceso necesita el agente.
Finalmente se define el significado empresarial de los conceptos relevantes.
El recorrido puede resumirse así:
Dato bruto → dato limpio → dato integrado → dato contextualizado → dato gobernado → dato utilizable por agentes.
Cada etapa elimina una fuente potencial de error.
Preparar los datos antes de aumentar la autonomía
La tentación habitual consiste en comenzar por el agente.
Elegir una herramienta.
Crear una demostración.
Conectarla rápidamente a varias fuentes.
Pero una prueba que funciona con diez documentos seleccionados no demuestra necesariamente que el sistema pueda operar sobre miles de registros reales.
La preparación de datos permite invertir ese orden.
Primero se determina qué proceso merece automatizarse.
Después se identifican los datos necesarios.
Se corrigen problemas de calidad e integración.
Se establecen permisos.
Y entonces se introduce el agente.
Esta secuencia reduce la probabilidad de descubrir problemas estructurales cuando la automatización ya depende de ellos.
El dato como infraestructura empresarial
La preparación de datos ha dejado de ser una tarea secundaria reservada al departamento IT.
Cuando una empresa quiere delegar procesos en agentes, sus datos pasan a formar parte directa de la infraestructura operativa.
Un dato incorrecto ya no afecta únicamente a un informe.
Puede afectar a una acción.
Por eso, cuanto mayor sea la autonomía de la IA, mayor debe ser la calidad del sistema que proporciona su contexto.
Las empresas que construyan esta base podrán avanzar desde asistentes aislados hacia agentes capaces de trabajar sobre procesos completos.
Y la dirección podrá delegar progresivamente parte de la supervisión operativa para recuperar entre 10 y 15 horas semanales destinadas hoy al procesamiento y revisión de información.
La ventaja no estará únicamente en disponer de mejores modelos de IA.
Estará en conseguir que esos modelos comprendan mejor el negocio.
Antes de invertir un solo euro más en nuevas licencias, conviene responder una pregunta:
¿podría un agente encontrar hoy la información correcta, entender qué significa y saber si tiene permiso para utilizarla?
Si cualquiera de esas tres respuestas genera dudas, la prioridad está clara.
Primero hay que preparar los datos.